技术取证显示中国AI巨头疑似已获 Blackwell 芯片
⚡ 核心要点提炼与关键事实
- 【核心事件】DeepSeek、Moonshot AI、MiniMax、蚂蚁集团在AI模型开源权重数据:通过模型权重指纹分析,确认模型训练过程中使用了受管制的高端 Blackwell 芯片
- 【起因与机理】验证中国科技公司在极端出口限制下的算力基础设施获取能力与应用现状
- 【关键技术规格】利用模型权重指纹技术逆向推导底层训练硬件。
- 【行业影响与走向】揭示出口管制下的高性能芯片流向风险与监管盲区。
🤖 雷达专属 AI 研判与技术透视
此项取证结果揭示了出口管制政策在实际执行层面的结构性漏洞,即算力供应已具备超越实体封锁的隐性流转渠道。这将倒逼美国商务部对芯片出口监管采取更激进的实地追踪及云端算力访问限制,未来针对“算力租赁”与“离岸训练”的合规审计将成为地缘科技博弈的重点。
📰 深度报道原文实录
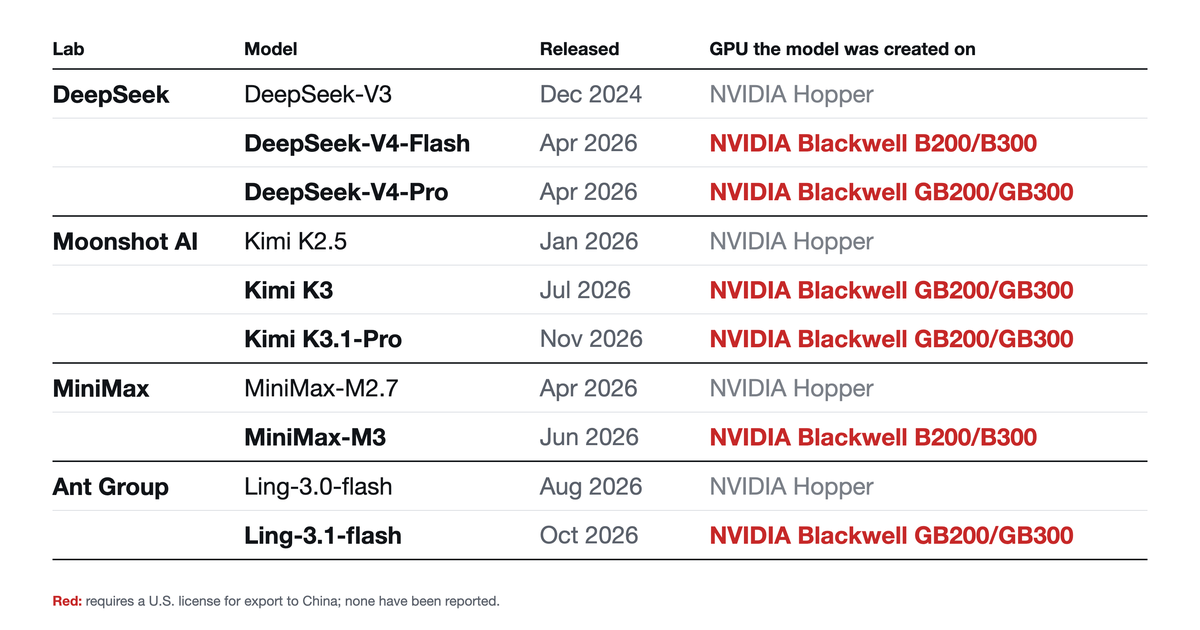
Unemployment Labs 权威实录我们对公开发布的 AI 模型进行的取证分析发现,证据表明 DeepSeek、Moonshot AI、MiniMax 和 Ant Group 已经获得了 NVIDIA Blackwell GPU 的使用权,尽管这些芯片向中国出口受到限制,并且正在使用该硬件来创建自己的 AI 模型。自 2026 年 4 月以来,这些公司发布的六款模型包含与 Blackwell 硬件匹配的数字模式,而同一家公司的早期模型则与 NVIDIA 的老一代 Hopper 匹配。研究结果表明,几家领先的中国人工智能开发商已经开始使用 Blackwell 来训练他们的最新模型。美国官员和媒体报道已经声称 DeepSeek 和 Moonshot AI 使用 Blackwell 芯片,但没有公布技术证据。
证据完全来自模型自己公布的权重,而不是来自泄密或内部人士的说法。我们恢复模型初始值的痕迹,然后搜索重现它们的硬件配置和初始配置;对于 DeepSeek-V4-Flash 和 Kimi K3,我们还在物理 Blackwell 芯片上确认了匹配。指纹识别了权重是如何创建的,并且在没有证明的情况下支持布莱克威尔也进行了训练的推论。特别配置的AMD硬件,也被限制出口到中国,是我们确定的唯一替代方案;我们已将 DeepSeek-V4-Flash 排除在外,并认为其他五个模型不太可能出现这种情况。值得注意的是,我们的研究结果提供了访问先进计算硬件的技术证据,但没有确定芯片位于何处、如何获得访问权限或是否违反出口管制。
表 1. DeepSeek、Moonshot AI、MiniMax 和 Ant Group 连续模型中的硬件指纹 Link ↗
• 向中国出口需要美国许可证;尚未有任何报道。
Hopper 指纹无法区分 H800 与 H100 SXM 或 H200;上述 H800 标识是实验室披露的信息,而不是该方法的结果。
表 2. 每次训练运行的粗略规模 Link ↗
训练计算(大约 6 × 活动参数 × 训练令牌)除以 35% 利用率下的芯片吞吐量,运行时间为两到三个月(DeepSeek-V4-Flash 为六到八周)。 DeepSeek 披露了其代币数量;对于其他模型,我们根据权重进行估计。
模型的权重(也称为参数)是数十亿个可调整的数字,决定模型如何处理信息并生成答案。训练反复调整这些数字;但在训练开始之前,他们需要初始值。在这里检查的软件中,这些值来自称为 Philox 的伪随机数生成 (PRNG) 算法:Philox 以确定性方式生成看似随机的数字。 Philox 的起始输入是一个称为“种子”的数字。给定相同的种子和设置,Philox 每次都会产生相同的数字。这使得工程师可以从相同的起点重复实验。
为了快速填充数十亿个权重,PyTorch(用于开发大多数主要人工智能模型的软件框架)将 Philox 的工作分配给 GPU 上的许多并行工作人员(称为线程)。 (它通过 cuRAND(NVIDIA 的随机数生成库)来实现这一点。)每个线程从种子生成自己的数字序列并填充一组特定的位置。然后线程的数量决定了如何共享这些位置。在此处检查的 NVIDIA 芯片上,足够大的初始化对每个处理单元使用最多 2,048 个线程,称为流式多处理器 (SM)。因此,具有更多 SM 的芯片会将相同的工作分配给更多的工人,从而改变他们的人数去向。
图 1 说明了它在具有 6 个 SM 和每个 SM 8 个线程(总共 48 个线程)的简化 GPU 上的工作原理。将权重想象为一长排空盒子,包裹在网格中以适合页面。第一个线程填充第一个框,第二个线程填充第二个框,依此类推,直到所有 48 个线程。然后,第一个线程的下一个数字进入框 49,其下一个数字进入框 97,依此类推。黑色轮廓沿着这条线穿过网格:第一条线填充每 48 个位置。颜色标识哪个处理单元提供每组值,而右侧面板中的亮度代表值本身。
现在保持种子固定,但使用具有五个 SM(而不是六个)的 GPU。在我们的简化示例中,这意味着 40 个线程而不是 48 个。第一个线程生成完全相同的序列,但现在将其数字放入框 1、41、81 等中,而不是框 1、49、97。图 2 跟随这些数字的位置变化。在整个网格中,只有 6% 的值与原始排列相符。种子是正确的,但工人计数是错误的。这就是模型权重的排列成为用于创建模型的芯片的线索的原因。
因此,再现权重需要同时满足两件事。种子必须生成正确的数字,并且线程计数必须将它们放在正确的位置。具有错误线程数的正确种子大多会在错误位置给出正确的数字;正确的线程计数和错误的种子会给出不同的数字。图 3 显示了为什么只有正确的组合才能重新创建原始排列。
在真实的芯片上,线程数要多得多,但原理是相同的。在此处检查的 NVIDIA 配置中,Hopper H100 SXM、H200 和 H800 有 132 个 SM,使用 270,336 个线程; Blackwell B200/B300 有 148 个 SM,使用 303,104 个线程; Blackwell GB200/GB300 有 152 个 SM,使用 311,296 个线程。因此,恢复线程计数可以告诉我们哪些硬件组与起始排列匹配,尽管它无法区分组内的芯片。例如,Hopper 匹配无法区分 H800 和 H100 或 H200。
问题是这种安排是否有足够的内容在训练中幸存下来供我们恢复。一些权重,例如为训练期间从未遇到过的单词或符号保留的权重,可以保持不变并几乎完全保留其初始值。我们可以将这些保留的值直接与候选种子和线程计数生成的起始值进行比较。图 4 显示了这样的比较:DeepSeek-V3 的保留权重与 Hopper 排列匹配,而 DeepSeek-V4-Flash 的保留权重与 Blackwell 排列匹配。